
Vera Rubin NVL72 expande rendimiento de inferencia generando 3.400 tokens por segundo
Empresas de nube de IA como Nevius adoptan la tecnología iniciando competencia formal en infraestructura de inferencia
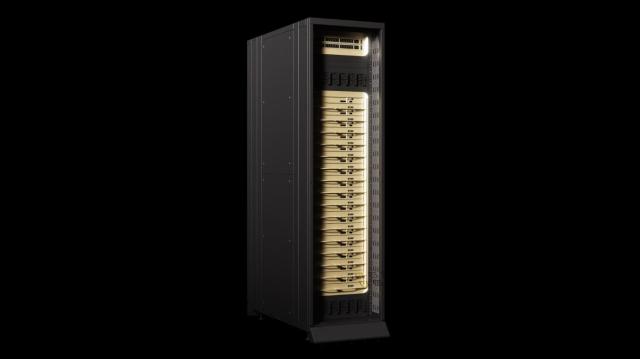
Nvidia ha iniciado la producción en masa del acelerador de inferencia 'Grok3 LPX', diseñado para aumentar la velocidad de respuesta de los agentes de IA. La compañía avanza más allá de la tradicional competencia en rendimiento de computación de IA para procesamiento de grandes volúmenes de datos, dando paso a una competencia formal en infraestructura centrada en la 'velocidad de generación de tokens', aspecto crítico de los agentes de IA agentic.
Nvidia anunció el 25 de agosto en el evento HotChips, celebrado en Santa Clara, California, el inicio de la producción en masa de Grok3 LPX. Se trata de un acelerador de inferencia de IA interactiva que amplía la plataforma de próxima generación Vera Rubin de Nvidia.
Los agentes de IA realizan tareas complejas mediante la repetición de múltiples etapas de razonamiento e invocación de herramientas. En este proceso, cuanto mayor sea el volumen de tokens generados, más crítica resulta la velocidad de generación de tokens individuales para el tiempo total de ejecución. Nvidia señaló que Grok3 LPX se enfoca específicamente en optimizar este aspecto.
La compañía también reveló métricas de rendimiento. De acuerdo con Nvidia, Grok3 LPX registró 3.400 tokens de salida por segundo en el benchmark Artificial Analysis, utilizando el modelo agentic de código abierto Gemma4 31B. Esta cifra representa la velocidad máxima del modelo bajo condiciones con un contexto de 100.000 tokens.
Nvidia indicó que Grok3 LPX proporciona velocidades de respuesta hasta 4 veces más rápidas que plataformas similares en tareas sensibles a la latencia, como la programación agentic. La solución se enfoca en reducir los tiempos de ejecución de agentes de IA que realizan tareas repetitivas: desde la escritura y prueba de código hasta la revisión de archivos y validación de resultados.
Grok3 LPX complementa el rendimiento de inferencia del sistema Vera Rubin NVL72. Vera Rubin es una plataforma que respalda tanto el entrenamiento como la inferencia de modelos de IA de gran escala. Al integrar Grok3 LPX, especializado en velocidad de generación de tokens, se crea una arquitectura que aborda simultáneamente los dos requisitos fundamentales de los agentes de IA agentic: procesamiento de contextos grandes y respuestas en tiempo real.
Empresas de nube de IA ya han comenzado la adopción. Nevius planea integrar Grok3 LPX en su plataforma de inferencia de producción 'Nevius Token Factory', permitiendo a los desarrolladores mantener sus API existentes mientras aprovechan capacidades de generación ultra rápida de tokens. Grok, empresa de inferencia de IA, será también uno de los primeros en adoptar la tecnología.
Esta iniciativa de producción en masa es significativa porque refleja un cambio en los criterios de competencia de la infraestructura de IA. Conforme la IA generativa evoluciona desde responder preguntas hacia sistemas agentic que planifican de forma autónoma y ejecutan múltiples tareas, métricas como la latencia de respuesta y la velocidad de generación de tokens emergen como indicadores críticos de rendimiento, junto a la capacidad de procesamiento computacional puro.
Nvidia está construyendo sistemas de rack completos en su plataforma Vera Rubin que integran CPU, DPU, almacenamiento y conectividad Ethernet. La estrategia de la compañía es optimizar la plataforma completa, incluyendo Grok3 LPX, para las cargas de trabajo de agentes de IA, manteniendo el liderazgo en infraestructura de inferencia en el mercado de centros de datos de IA.
* Este artículo ha sido traducido por IA.