
Modelos de 3.000 millones y 1.300 millones de parámetros publicados para mejorar búsqueda de información en coreano
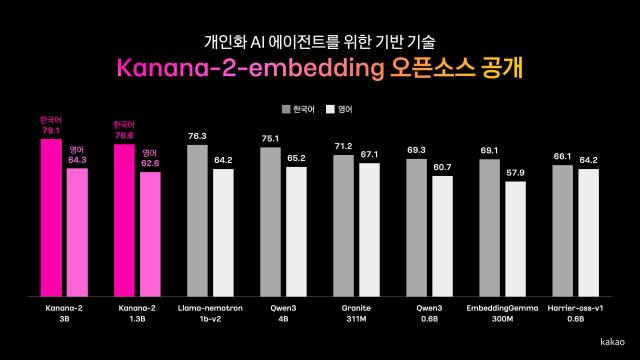
Kakao ha presentado una tecnología de inteligencia artificial (IA) que busca información necesaria basada en el contexto de conversación con los usuarios. La compañía ha distribuido modelos de incrustación (embedding) como código abierto, permitiendo que la IA no solo responda preguntas, sino que también realice búsquedas de información que se adapten al contexto de conversaciones pasadas y a cada usuario.
Kakao anunció que ha publicado dos versiones del modelo de incrustación "Kanana 2 Embedding", tecnología fundamental para agentes de IA personalizados, en la plataforma de código abierto Hugging Face, informó la compañía el 29 de octubre.
Los modelos presentados son "Kanana-2-3b-Embedding", con 3.000 millones de parámetros, y "Kanana-2-1.3b-Embedding", con 1.300 millones de parámetros. Esta es una medida de seguimiento tras la publicación en julio de cuatro modelos de lenguaje pequeño (SLM). Kakao continúa desarrollando tecnologías de búsqueda de información avanzadas basadas en su propio modelo de lenguaje, con el objetivo de crear modelos que puedan utilizarse en diversos entornos de servicio.
Los modelos de incrustación son tecnologías que convierten el significado del texto en valores numéricos para encontrar información relacionada con una pregunta. Mientras que los modelos de lenguaje convencionales se enfocan en entender preguntas y generar respuestas, los modelos de incrustación calculan la similitud semántica entre una pregunta e información, desempeñando el rol de buscar los datos necesarios para la respuesta.
Por ejemplo, cuando un usuario intenta encontrar un restaurante mencionado en una conversación anterior sin introducir el nombre exacto del establecimiento, puede realizar búsquedas de información relacionada utilizando expresiones con contexto como "el restaurante tranquilo del que hablamos antes" o "un lugar bueno para conversar". El agente de IA personalizado ayuda a encontrar la información necesaria a partir de conversaciones previas para utilizarla en sus respuestas.
Kakao desarrolló el modelo de 3.000 millones de parámetros basándose en su modelo de lenguaje pequeño propio "Kanana-2-SLM", entrenando la capacidad de comprensión del lenguaje para su aplicación en búsqueda de información. Posteriormente, aplicó técnicas de destilación de conocimiento, que transfieren el conocimiento aprendido por modelos grandes a modelos más pequeños, para construir el modelo de 1.300 millones de parámetros. El objetivo era reducir el tamaño del modelo mientras se conservaba el desempeño y la eficiencia necesarios para la búsqueda de información.
Kakao planea continuar investigaciones en aprendizaje de incrustación utilizando modelos de lenguaje más grandes y destilación de conocimiento para mejorar tanto el desempeño de búsqueda como la eficiencia.
Noh Byoung-seok, líder de logros en modelos fundamentales unificados de Kakao, declaró: "Para que los agentes de IA proporcionen la ayuda que los usuarios necesitan, es importante no solo la capacidad de responder preguntas, sino también la tecnología para encontrar información necesaria de forma precisa entre información dispersa". Agregó: "A través de esta publicación, esperamos ayudar a investigadores y desarrolladores a aplicar tecnología de incrustación con fortaleza en idioma coreano en diversos servicios, y continuaremos investigaciones que mejoren tanto el desempeño como la eficiencia de búsqueda".
* Este artículo ha sido traducido por IA.