
Claude, Gemini y GPT logran la puntuación máxima de 426 puntos; la IA china también compite en el top
El modelo surcoreano 'K-EXAONE 2.5' de LG AI Research encabeza los modelos nacionales con puntuación perfecta en matemáticas y 120 puntos en lengua
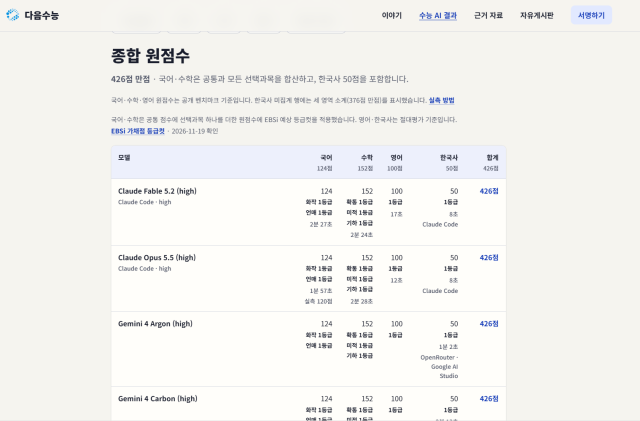
Según la plataforma de benchmark de IA para el examen 'Daum Suneung' divulgado el 20 de noviembre, la evaluación se llevó a cabo el 19 de noviembre, el día posterior al examen, ingresando los problemas en los modelos de IA para resolver y calificar. La puntuación se basa en una calificación máxima de 426 puntos: lengua 124 puntos, matemáticas 152 puntos, inglés 100 puntos e historia de Corea 50 puntos. Para lengua (oratoria y escritura; lenguaje y medios) y matemáticas (probabilidad y estadística; cálculo; geometría), se sumaron todas las puntuaciones de las asignaturas comunes y optativas.
Un total de 9 modelos y configuraciones obtuvieron la puntuación perfecta en todas las áreas (426 puntos). Por desarrollador: ▲'Claude Fable 5.2' y 'Claude Opus 5.5' de Anthropic ▲'Gemini 4 Argon, Carbón, Hidrógeno y Neón' de Google ▲'GPT-6.1 Terra', 'GPT-6.2 Astra y Sol' de OpenAI.
También destacaron los modelos de alto rendimiento que faltaron por poco para obtener la puntuación perfecta. El 'Claude Sonnet 5.5' de Anthropic obtuvo 422 puntos (lengua 122, matemáticas 152, inglés 98, historia de Corea 50), mientras que el 'Claude Haiku 5.5' registró 420 puntos (lengua 120, matemáticas 152, inglés 98, historia de Corea 50).
También se confirmó el avance de los modelos de IA chinos. El 'Kimi K3.1 Pro' de Moonshot AI recibió una deducción de solo 4 puntos en matemáticas, logrando un total de 422 puntos (lengua 124, matemáticas 148, inglés 100, historia de Corea 50), mientras que el 'Qwen 4 Max' de Alibaba también registró 420 puntos (lengua 124, matemáticas 148, inglés 100, historia de Corea 48), incluida la puntuación perfecta en lengua e inglés.
Entre los modelos ligeros, el 'GPT-6 Luna' de OpenAI obtuvo 416 puntos (lengua 122, matemáticas 149, inglés 100, historia de Corea 45), mientras que el 'Gemini 3.5 Flash Lite' de Google registró 384 puntos (lengua 116, matemáticas 128, inglés 95, historia de Corea 45).
Entre los modelos de IA desarrollados en Corea del Sur, el 'K-EXAONE 2.5' del Centro de Investigación de IA de LG encabezó la clasificación con 368 puntos en tres áreas (lengua, matemáticas e inglés combinadas: lengua 120, matemáticas 152, inglés 96). En particular, obtuvo puntuación perfecta en el área de matemáticas, incluyendo todas las asignaturas optativas.
Le siguieron ▲'Sola Mini 4.5 Preview' de Upstage con 352 puntos (lengua 111, matemáticas 145, inglés 96) ▲'Sola Pro 4' de Upstage con 346 puntos (lengua 109, matemáticas 149, inglés 88) ▲'Raon-1 Mini Preview' de Krafton con 338 puntos (lengua 101, matemáticas 146, inglés 91) ▲'Minu:m K 3.0 Pro' de KT con 317 puntos (lengua 74, matemáticas 149, inglés 94). En general, los modelos surcoreanos mostraron fortaleza en matemáticas, mientras que presentaron variaciones significativas en el área de lengua según el modelo.
Sin embargo, algunos de los modelos evaluados, incluidos los nacionales, no registraron puntuaciones en historia de Corea, por lo que solo se publicaron los totales de tres áreas (puntuación máxima de 376 puntos). Por lo tanto, existe una limitación en la comparación directa de puntuaciones totales entre estos modelos y los que alcanzaron la puntuación máxima de 426 puntos incluida la historia de Corea.
Estas puntuaciones corresponden a un sistema de puntuación bruta personalizado que suma todas las asignaturas optativas y difieren de las puntuaciones estándar que aparecen en los certificados de calificaciones de los estudiantes reales. Además, debido a las diferencias en la configuración de ejecución y el método de entrada entre modelos, es difícil determinar el desempeño general de la IA basándose únicamente en estos números.
* Este artículo ha sido traducido por IA.