
La demanda de carga de trabajo de IA alcanzará 156GW en 2030…La minimización de GPU ociosas es crucial ante la presión energética y de refrigeración
Kakao analiza la conversión de GPU por franja horaria…Elice optimiza la infraestructura según aprendizaje e inferencia
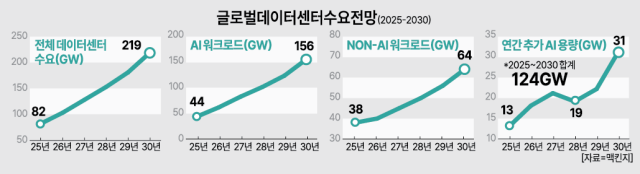
Según el análisis de McKinsey basado en datos de Gartner, IDC y Nvidia, la demanda global de carga de trabajo de IA en centros de datos se proyecta que crecerá aproximadamente 3.5 veces, pasando de 44GW en 2025 a 156GW en 2030. Se espera que la demanda total de centros de datos también aumente en el mismo período, de 82GW a 219GW. En particular, la demanda de inferencia de IA crecerá a una tasa anual promedio del 35% (de 20.9GW en 2025 a 93.3GW en 2030), superando la tasa de crecimiento de la demanda de aprendizaje del 22%.
La razón por la que simplemente adquirir más GPU resulta insuficiente para responder a la creciente demanda de cálculo radica en que, conforme se implementan GPU de alto rendimiento a gran escala, aumenta la densidad de potencia por bastidor y también se incrementan los desafíos de refrigeración. En los centros de datos de IA, se está observando un movimiento hacia la adopción de nuevas tecnologías de refrigeración, como la refrigeración líquida, para hacer frente a entornos de GPU de alta densidad.
La industria también presta atención a métodos para distribuir GPU de manera eficiente aprovechando las características de los dos principales tipos de carga de trabajo de IA: aprendizaje e inferencia. El aprendizaje realiza cálculos a gran escala de manera intensiva pero puede tolerar ciertos niveles de latencia o interrupciones en las tareas, mientras que la inferencia debe proporcionar resultados en tiempo real a los usuarios, por lo que requiere baja latencia y capacidad de procesamiento estable.
McKinsey analiza que estas diferencias en características harán que el aprendizaje y la inferencia tengan impactos distintos en la ubicación, diseño y estrategia de suministro de energía del centro de datos.
En un informe publicado en marzo, Red Hat presentó esta estrategia bajo el concepto de "inferencia de día, aprendizaje de noche". Red Hat explicó que las tareas de inferencia requieren baja latencia y disponibilidad continua para responder en tiempo real, mientras que las tareas de aprendizaje pueden tolerar relativemente más latencia e interrupciones, siendo por lo tanto más adecuadas para distribuirse durante las horas nocturnas cuando la demanda de inferencia disminuye. Además, propuso que mediante orquestación que asigne dinámicamente recursos de GPU según la demanda en tiempo real, es posible reducir las GPU ociosas.
En Corea del Sur también esta estrategia está emergiendo como una alternativa para mejorar la eficiencia de las GPU. Kakao está considerando un método de utilización de GPU por franja horaria mientras reflexiona sobre planes futuros de operación de infraestructura de IA. Kim Se-ung, vicepresidente de Sinergia de IA de Kakao, afirmó: "Considero que el modelo operativo de GPU al estilo coreano consiste en utilizar servidores de inferencia que requieren respuesta en tiempo real durante el día según el tráfico, y reunir las GPU restantes para destinarlas al aprendizaje durante la noche".
Las empresas coreanas de infraestructura de IA están mejorando la eficiencia no solo mediante la asignación de recursos por franja horaria, sino también diseñando centros de datos según las características específicas de la carga de trabajo. Elice Group diseña su centro de datos modular de IA (PMDC) de manera diferenciada según los requisitos de aprendizaje e inferencia. Para el aprendizaje, utiliza GPU y agrupamiento de ultra baja latencia para garantizar máximo rendimiento, mientras que para la inferencia enfatiza una estructura con NPU, alta disponibilidad y eficiencia de costos.
Un representante del sector afirmó: "En un centro de datos de IA, es importante no solo cuántas GPU se han adquirido, sino también cuán eficientemente se utilizan las GPU adquiridas en cálculos reales. Como las características de inferencia y aprendizaje son distintas, distribuir GPU de manera flexible de acuerdo con las condiciones de tráfico y energía, y mejorar la eficiencia de la infraestructura como la refrigeración, será lo que determine la competitividad operacional de los centros de datos en el futuro".
* Este artículo ha sido traducido por IA.