
El equipo del profesor Lee Yeon-chang de UNIST desarrolla 'EchoTrace'
Una investigación ha demostrado que los sistemas de recomendación de inteligencia artificial basados en modelos de lenguaje de gran tamaño (LLM) pueden generar una concentración en elementos específicos y repetir errores de recomendación cuando reapprenden sus propios resultados.
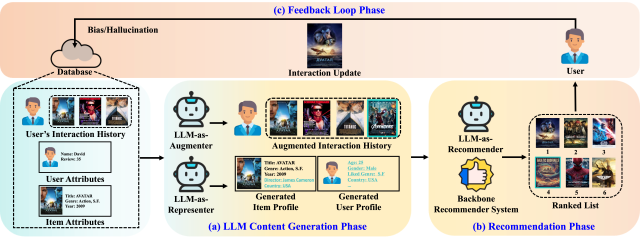
Según informó el 8 de noviembre el Instituto de Ciencia y Tecnología de Ulsan (UNIST), el equipo del profesor Lee Yeon-chang de la Escuela de Posgrado en IA desarrolló "EchoTrace", una herramienta de diagnóstico que rastrea cómo los sesgos y errores surgen y se acumulan en sistemas de recomendación basados en LLM. El equipo de investigación utilizó esta herramienta para analizar tres enfoques: cuando el LLM crea directamente listas de recomendación, cuando genera perfiles de usuario y cuando genera datos de aprendizaje.
Cuando el LLM creó directamente listas de recomendación, el porcentaje de elementos presentados que no estaban en los objetivos de recomendación fue del 4,07% para películas, 7,4% para libros y 13,14% para tiendas. Las profesiones de usuarios estimadas basadas en el historial de visualización de películas diferían del registro real en un 93,16%. Los datos generados para entrenamiento también mostraron sesgos hacia géneros o sectores específicos. En las recomendaciones finales, los elementos populares aparecieron con mayor frecuencia en comparación con el historial real de uso.
Incluso después de repetir el proceso de reaprendizaje de los resultados de recomendación cinco veces, los sesgos e errores iniciales no desaparecieron. En algunos sistemas, la concentración en elementos populares se intensificó. En particular, el modelo en el que el LLM recomendaba películas directamente mostró que entre 86 y 92 de cada 100 usuarios consideraban la obra previamente recomendada como la referencia más importante al elegir la siguiente película. El "bucle de retroalimentación", en el cual las recomendaciones generadas por IA se aprenden como registros de selección de usuarios y se reflejan nuevamente en las próximas recomendaciones, perpetuó los sesgos y errores iniciales.
El profesor Lee señaló que "esta investigación ha establecido una base para diagnosticar sistemáticamente, de acuerdo con el papel del LLM, cómo los sesgos y alucinaciones en sistemas de recomendación basados en LLM se acumulan y amplifican en procesos de recomendación repetitivos".
* Este artículo ha sido traducido por IA.